- •**腾讯网盘做的不是网盘,是 Agent 的默认工作区。**四项能力(存储、连接、智能、安全)单独看都不新鲜,难的是它们属于同一个账号体系和同一个额度池。
- •**它真正省掉的动作叫搬运上下文。**用过 AI 办公的人都知道,最累的不是提问,是提问之前把上周的纪要、上个月的方案、客户的邮件一个个复制进去。
- •**它还没碰的是「读得懂」和「哪封算数」。**文件有标题有目录,邮件和会议没有;同一个话题散在几十封往来里,还会互相推翻。这是检索和时效问题,不是存储问题。
- •**小团队要调整的不是功能表,是位置。**不做另一个存储入口,主动接进别人的生态,把力气放在最难啃的非结构化数据上。
- •**巨头做连接,小团队做理解。**连接会越来越便宜,理解不会。判断一个方向值不值得做,先问一句:这件事巨头做起来会不会嫌脏。
腾讯网盘做的其实不是网盘,是 Agent 的默认工作区
**它叫网盘,做的是另一件事:把 AI 办公产生的所有产物收进一个地方,让下一个 Agent 能接着用。**官方给了四项核心能力——存储、连接、智能、安全。单看每一条都不新鲜,真正难的是它们本来就属于同一个体系。
10 月 29 日,腾讯在全球数字生态大会上发布 Buddy One,同时开启腾讯网盘的内测申请。
官方给了四项核心能力,存储、连接、智能、安全。
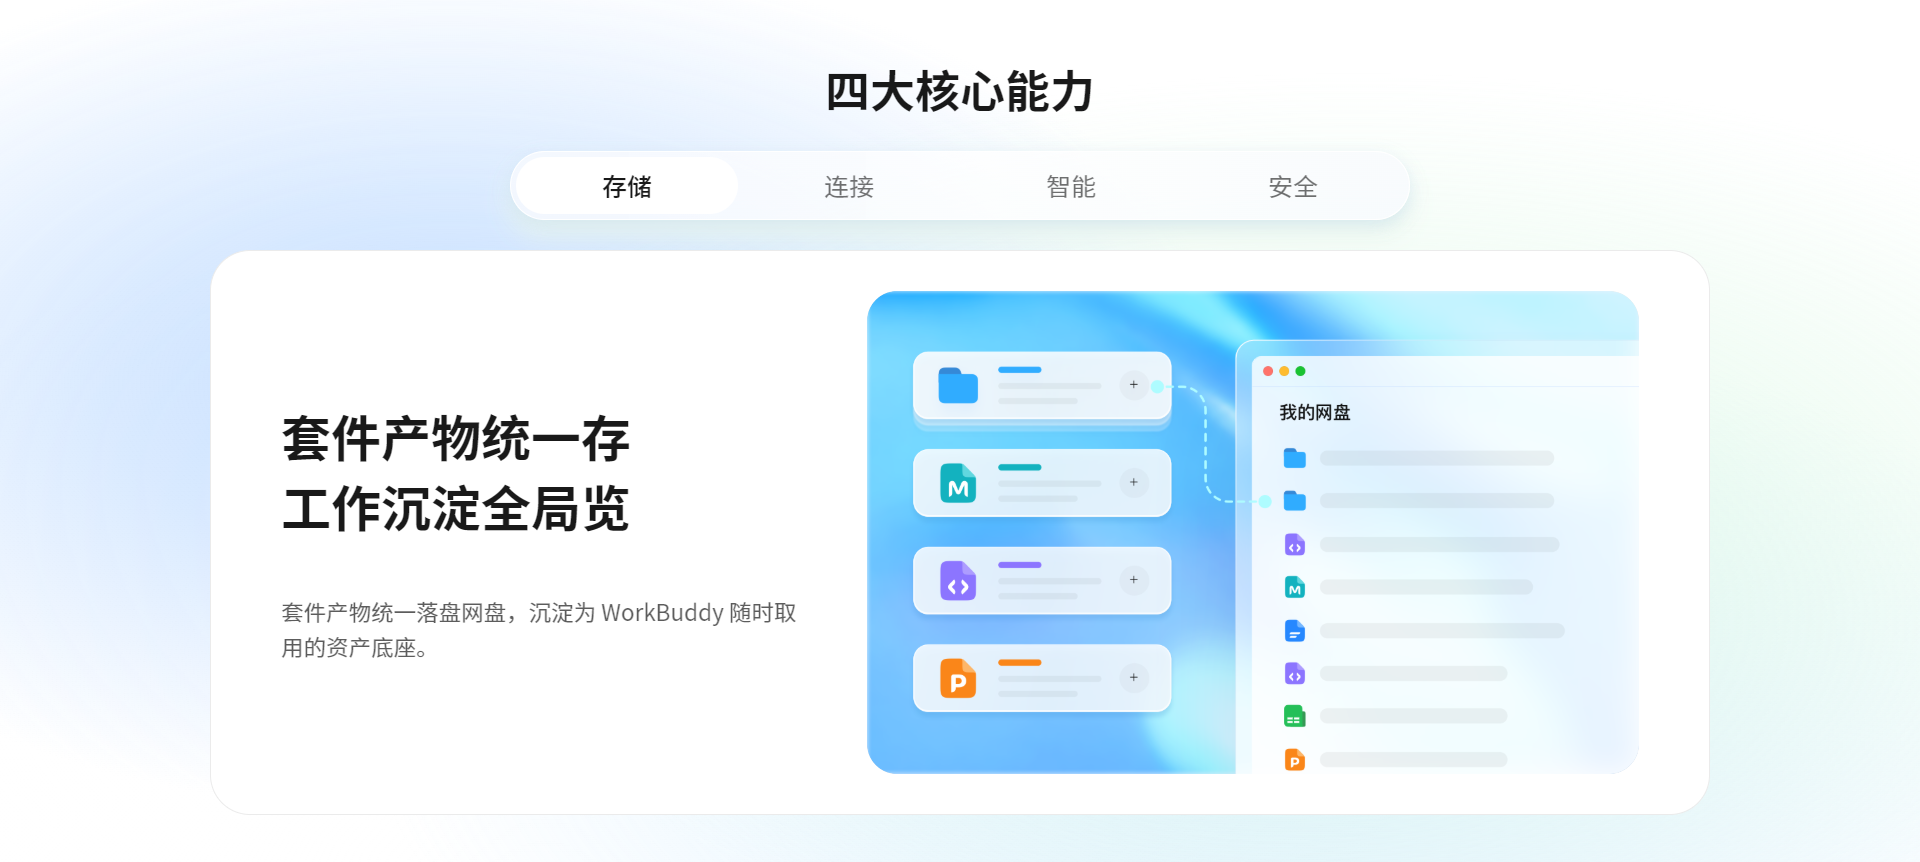
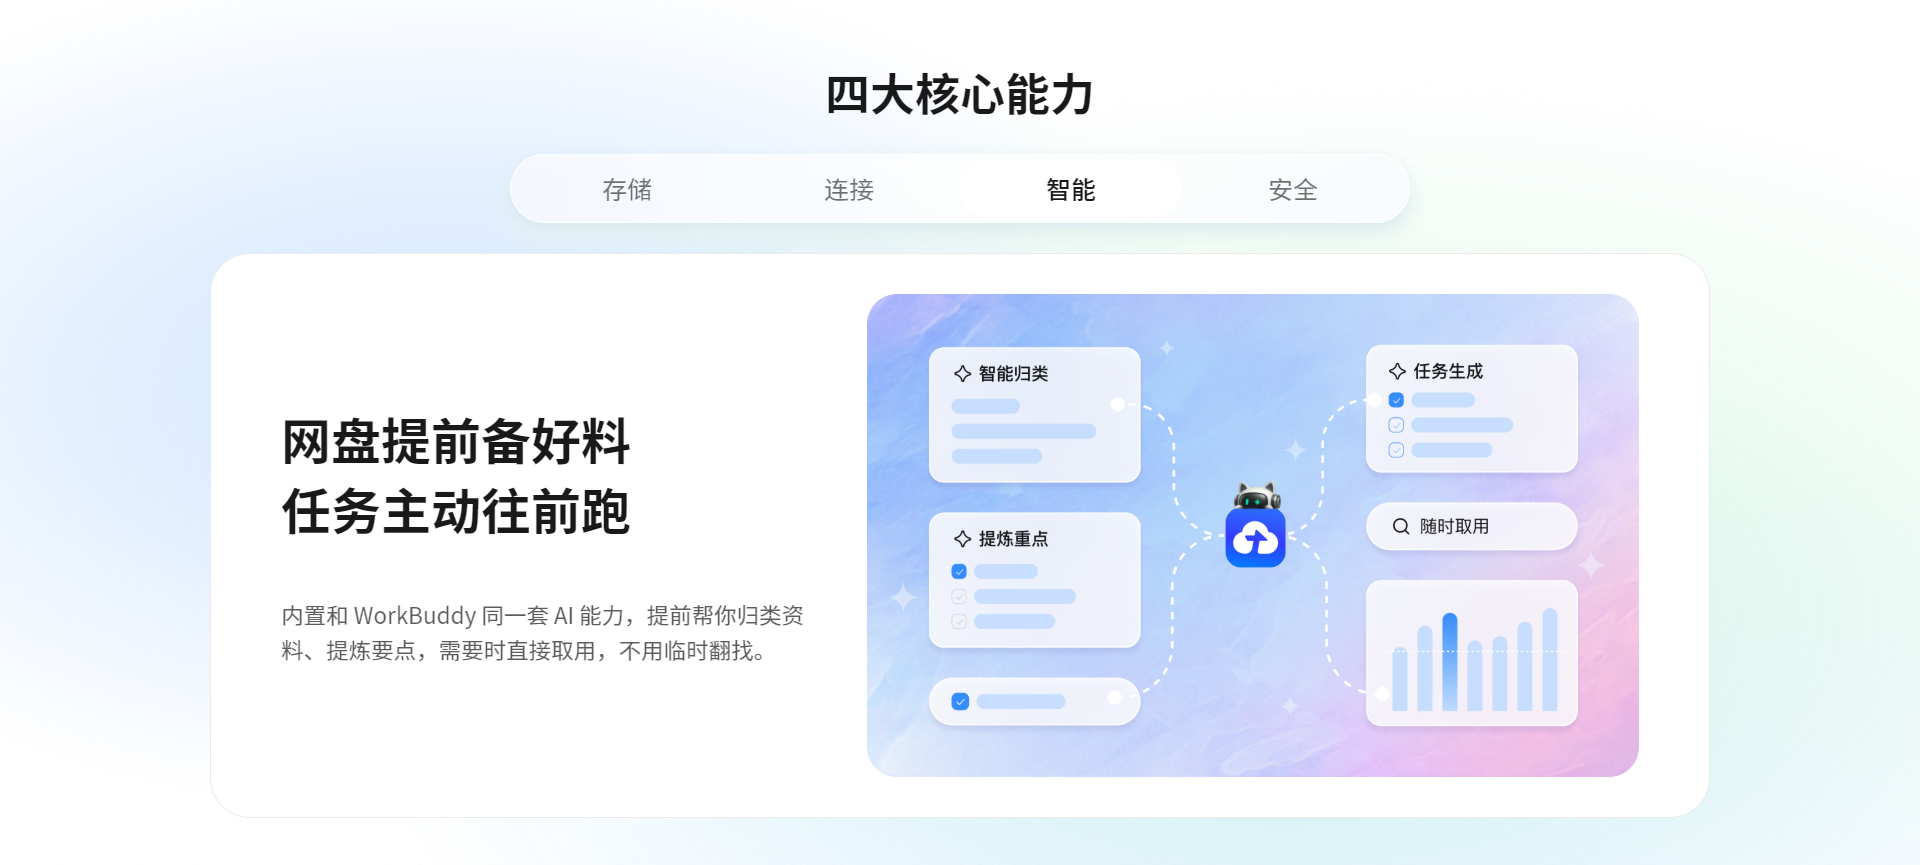
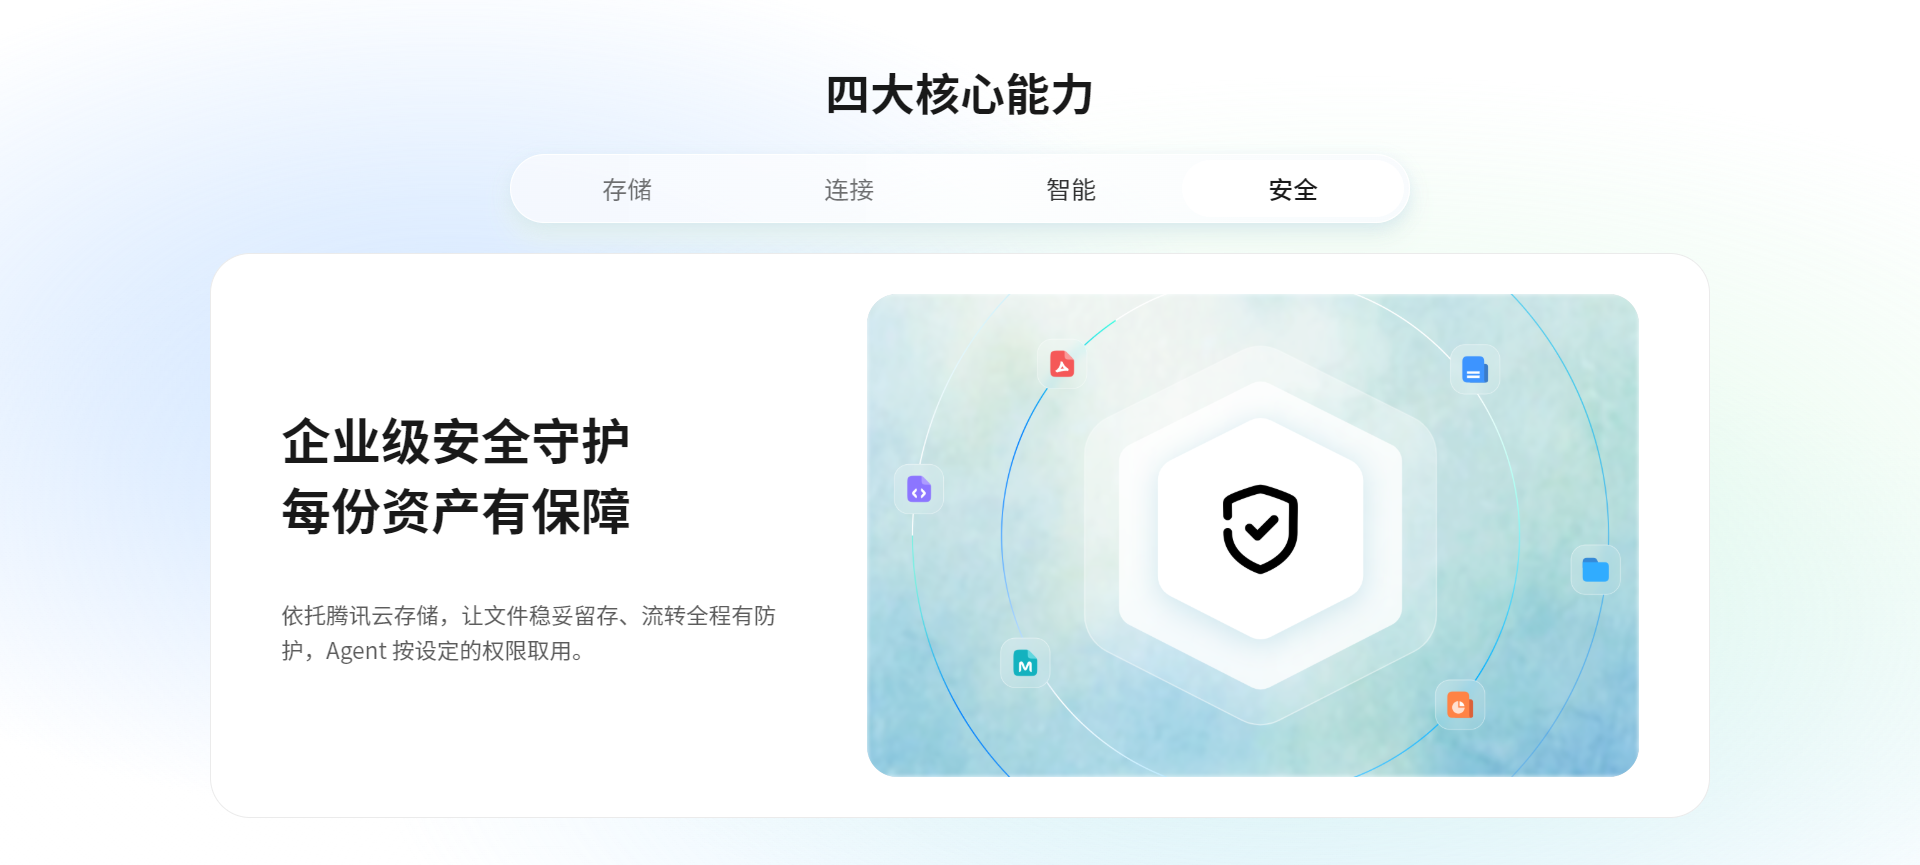
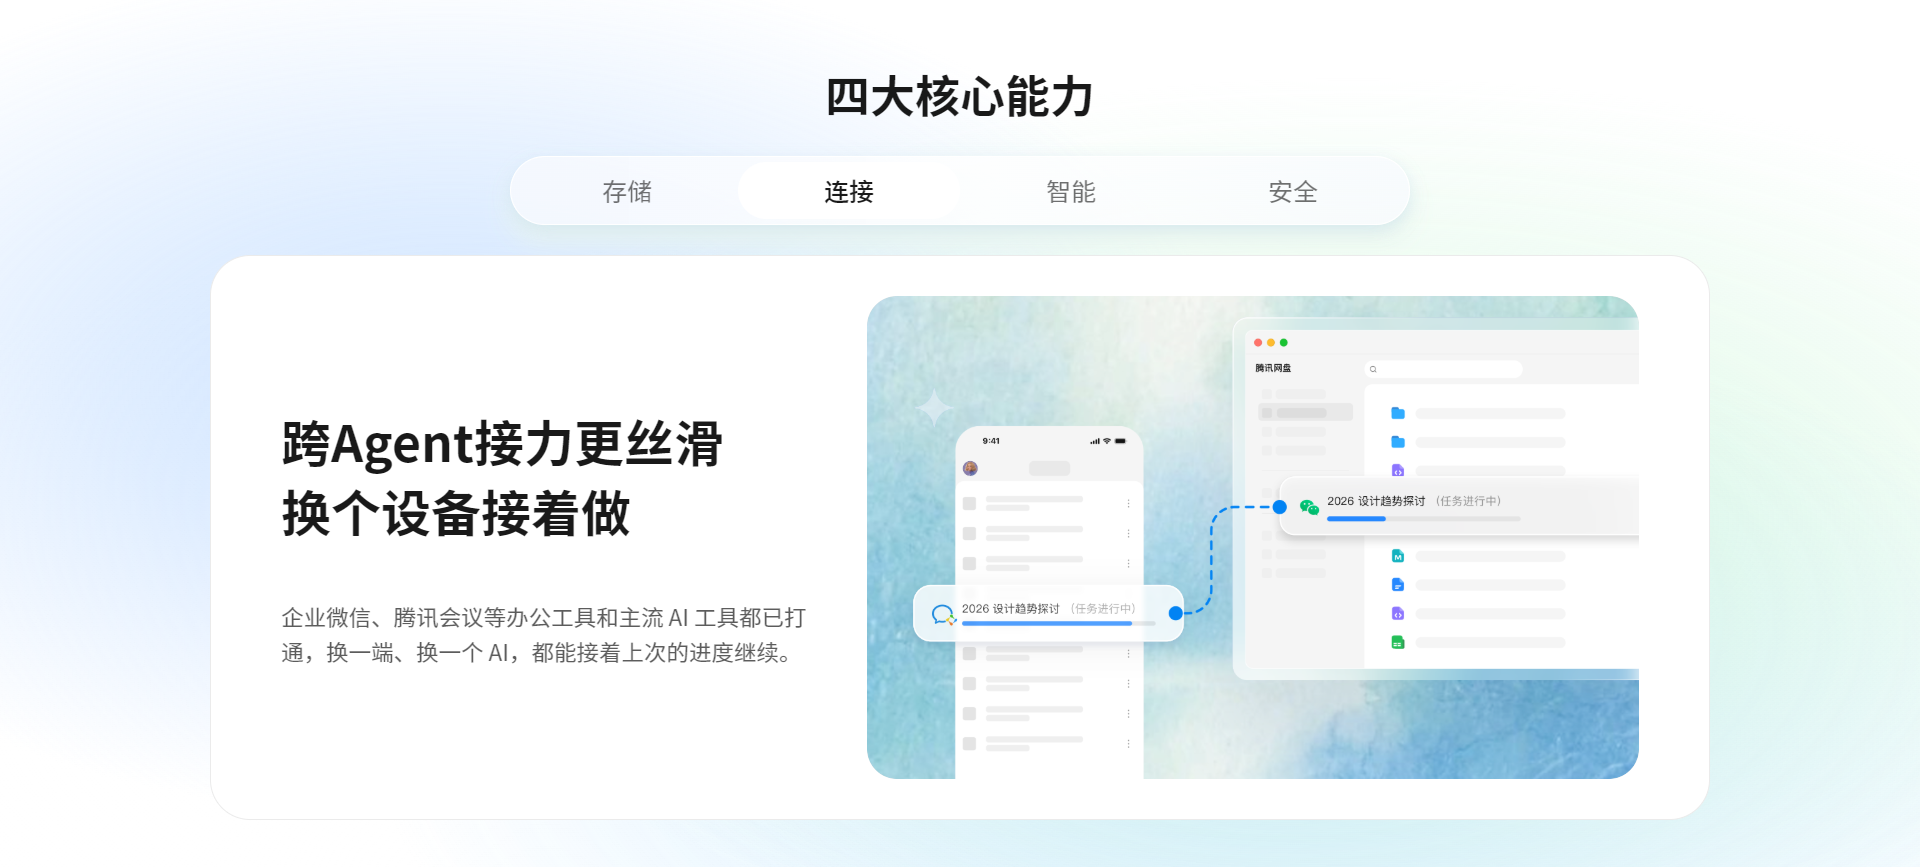
存储,是把 WorkBuddy 这套办公 Agent 的产物统一收进去,沉淀成随时能取用的资产底座。连接,企业微信、腾讯会议、腾讯文档、ima、飞书,还有第三方 Agent,都能接进来——你在一个工具里没做完的事,换个工具还能接着做。智能,内置和 WorkBuddy 同一套 AI 能力,负责资料归类、要点提炼。安全,依托腾讯云存储,文件留存和流转全程有防护,Agent 按设定权限取用。
但真正让它有价值的,是同一时间发布的 Buddy One。一个账号,一个积分池,一次搜索跨所有应用,命中的资料还会标明来自哪个应用。
这四项能力单独看都不新鲜。难的是它们本来就是一家人,账号通用、积分通用,不用为了存文件再养一套系统。当上下文不再被某个对话框独占,网盘就成了 Agent 的默认工作区。
它省掉的那个动作,叫搬运上下文
**用过 AI 办公的人都知道,最累的不是提问,是提问之前那一步。**把上周的会议纪要、上个月的方案、客户最后一封邮件,一个一个复制进去。腾讯网盘把这一步删掉了,并且承认了一个事实:模型再聪明,也不会凭空知道一家公司为什么放弃过某个方案。
用过 AI 办公的人都知道,最累的不是提问,是提问之前那一步。把上周的会议纪要、上个月的方案、客户最后一封邮件,一个一个复制进去。
腾讯网盘把这一步删掉了。
而且它承认了一个很多人不太愿意承认的事实。模型再聪明,也不会凭空知道一家公司为什么放弃过某个方案。决定 AI 输出质量的,不是模型有多强,而是你能交给它什么样的背景。
过去两年,模型能力在快速平权。同一个问题,各家给出的答案差距在缩小。真正拉开差距的,是喂给它的材料。
这也不是一家公司的动作。字节的 ADrive 已经开放试用,百度把 GenFlow 做成了库库 AI,阿里云盘企业版有了自己的 Agent,千问和夸克也打通了。巨头们都在同一个方向上试探——把「上下文」做成基础设施。
它还没碰的,是「读得懂」和「哪封算数」
**它现在处理的是文件。企业里最难处理的数据恰恰不是文件,是邮件、会议录音和 IM 里的长讨论。**这些东西没有标题、没有目录,一个话题散在几十封往来里还会自我推翻。文件被连进来只是让它找得到;找到之后还要读得懂,还要知道这一封和那一封哪一封说了算。
说一句公道话。它现在处理的是文件。
企业里最难处理的数据,恰恰不是文件。是邮件,是会议录音,是 IM 里动不动几百条的长讨论。
这些东西没有标题,没有目录,同一个话题散在几十封往来里,还会自我推翻。三月说按老交期,五月说要重新比价,七月说先不安排。单独看每一封都正常,连起来看,方向早就变了。
公开介绍里有一句话说得挺诚实:旧稿里的要求和最新确认的要求混在一起,AI 即使读到了文件,也可能继续沿用旧内容。
这是检索和时效的问题,不是存储的问题。文件被连进来,只是让它找得到。找到之后还要读得懂,还要知道这一封和那一封,哪一封说了算。
做邮件这几年,我们吃过太多这种亏。一份 2019 年的报价单,和一份 2025 年的报价单,在文件列表里长得一模一样。AI 分不出哪个算数,人也不想一封一封翻。
连接解决的是找得到。理解,是另一门手艺。巨头擅长把东西放到一起,难的是让它们不再互相打架。
小团队该调整的不是功能表,是位置
**面对平台级产品,功能对标是最差的一种反应。**更有效的做法是换位置:不做另一个存储入口,把上下文编译成可检索、可解释、可授权的形式,主动接进别人的生态,并且补上平台目前最缺的交接流程。
看到这条消息的当晚,我们把自己接下来三个月要做的事重新排了一遍。
第一,不做另一个网盘,做记忆编译器。把邮件、会议、长文档编译成可检索、可解释、可授权的上下文。存储和连接让给平台,我们只做编译。
第二,检索结果要能解释。为什么命中这一封,它属于哪个时间段,是不是已经被后面的邮件覆盖。这是最能解决「旧内容混用」问题的一刀。
第三,主动接入,不做孤岛。把上下文导出成标准包,做成接口,让外部的 Agent 能直接调我们的库。宁可做上游的数据源,也不和平台并列着抢一个入口。
第四,把交接补上。员工离职或者换岗,客户关系和研究结论要能跟着走。这是企业真正愿意付钱的地方,也是平台目前最缺的一块。
这四条里,没有一条是去跟腾讯网盘抢功能。抢不过,也不该抢。
守正出奇:去啃巨头嫌脏的地方
**守正,是把时间投到解析成本高、格式脏、隐私重、平台短期不愿碰的数据上。**出奇,是不跟平台抢入口,去做它的数据源。它越强,越需要一个能喂给它公司记忆的上游。
守正,是去啃巨头嫌脏的地方。邮件解析成本高,格式乱,隐私重,平台短期不愿意碰。这恰好是小团队唯一能把时间换成深度的战场。
出奇,是不跟它抢入口,去当它的数据源。它越强,越需要一个能喂给它公司记忆的上游。
巨头做连接,我们做理解。连接会越来越便宜,理解不会。
如果你也在用小团队做 AI 产品,别急着做功能对标。先问一句,这件事巨头做起来会不会嫌脏。
巨头不愿弯腰的地方,才有小团队的机会。
常见问题
平台开始做 Agent 网盘了,企业邮箱知识库还有必要吗?
有必要,但价值点会移动。平台擅长的是存储与连接,也就是让资料集中、让不同 Agent 接得上。企业邮箱知识库的价值在另一层:把几十封往来里的同一件事还原成「哪一封说了算」。前者解决找得到,后者解决读得懂,这两件事不能互相替代。
小团队还该不该做 AI 应用?会不会白做?
基础设施变便宜,对小团队其实是好事。存储、连接、算力这些层以后会像水电一样便宜,你不用再自己造。真正稀缺的是对某一类脏数据、某一个具体场景的理解深度。把力气从「造基础设施」移到「啃别人不愿啃的数据」,被替代的风险反而更低。
做的是「记忆编译器」,具体是什么意思?
指的是把原始的非结构化往来(邮件、会议记录、长文档),编译成结构化、带时间线、带来源、可被 AI 直接加载的上下文。它有三个硬要求:可检索、可解释(为什么命中这一条、它是否已被后续内容覆盖)、可授权(按组织权限管理谁能读什么)。存储只是把原料堆起来,编译才让原料变成能用的东西。
怎么判断一个方向值不值得投入?
除了市场大小,还值得问三个问题。这件事的数据脏不脏,脏意味着解析成本高,平台短期不愿碰。这件事错了代价大不大,代价大说明用户愿意为解决它付钱。这件事能不能被别人的生态直接调用,能被调用就不会变成孤岛。三个都成立,就算不上小生意。